OpenAI ouvre en bêta publique une API consacrée aux décisions structurées. Elle analyse du texte, des images ou leur combinaison afin de vérifier une condition, choisir une catégorie définie ou attribuer un niveau selon une grille. Pour une PME, cette brique vise moins la conversation que l’orientation rapide d’un workflow commercial ou opérationnel.
Son intégration exige toutefois une distinction nette entre recommandation automatisée et décision engageante. Le modèle fournit un résultat exploitable par un logiciel, tandis que l’entreprise conserve la responsabilité des critères, des actions déclenchées et des recours accordés aux utilisateurs.
Une brique spécialisée entre données et workflow
La documentation de l’API Decisions décrit un service destiné à produire des réponses typées. Une application reçoit ainsi une catégorie, une évaluation ordonnée ou l’estimation associée à une condition. Ces formats s’intègrent directement dans un CRM, une file de support ou un outil de gestion documentaire.
Dans un service commercial, un message entrant rejoint la bonne équipe selon des catégories établies. Dans les opérations, une photographie de produit retourné passe en revue lorsque des signes de dommage correspondent à la consigne. Un service client classe également les demandes selon une grille interne, sans demander au modèle de rédiger une longue justification.
Cette spécialisation ne remplace pas les outils génératifs. Une extraction de champs personnalisés, un compte rendu argumenté ou l’appel d’un logiciel métier relèvent d’une architecture différente. Le choix dépend donc de la sortie réellement attendue : verdict encadré, contenu rédigé ou action outillée.
Cette logique rejoint les critères présentés dans notre guide de choix d’un modèle pour PME et notre essai d’un modèle en contexte métier. Le nom du modèle compte moins que son adéquation avec les données, les règles et le niveau de contrôle du processus.
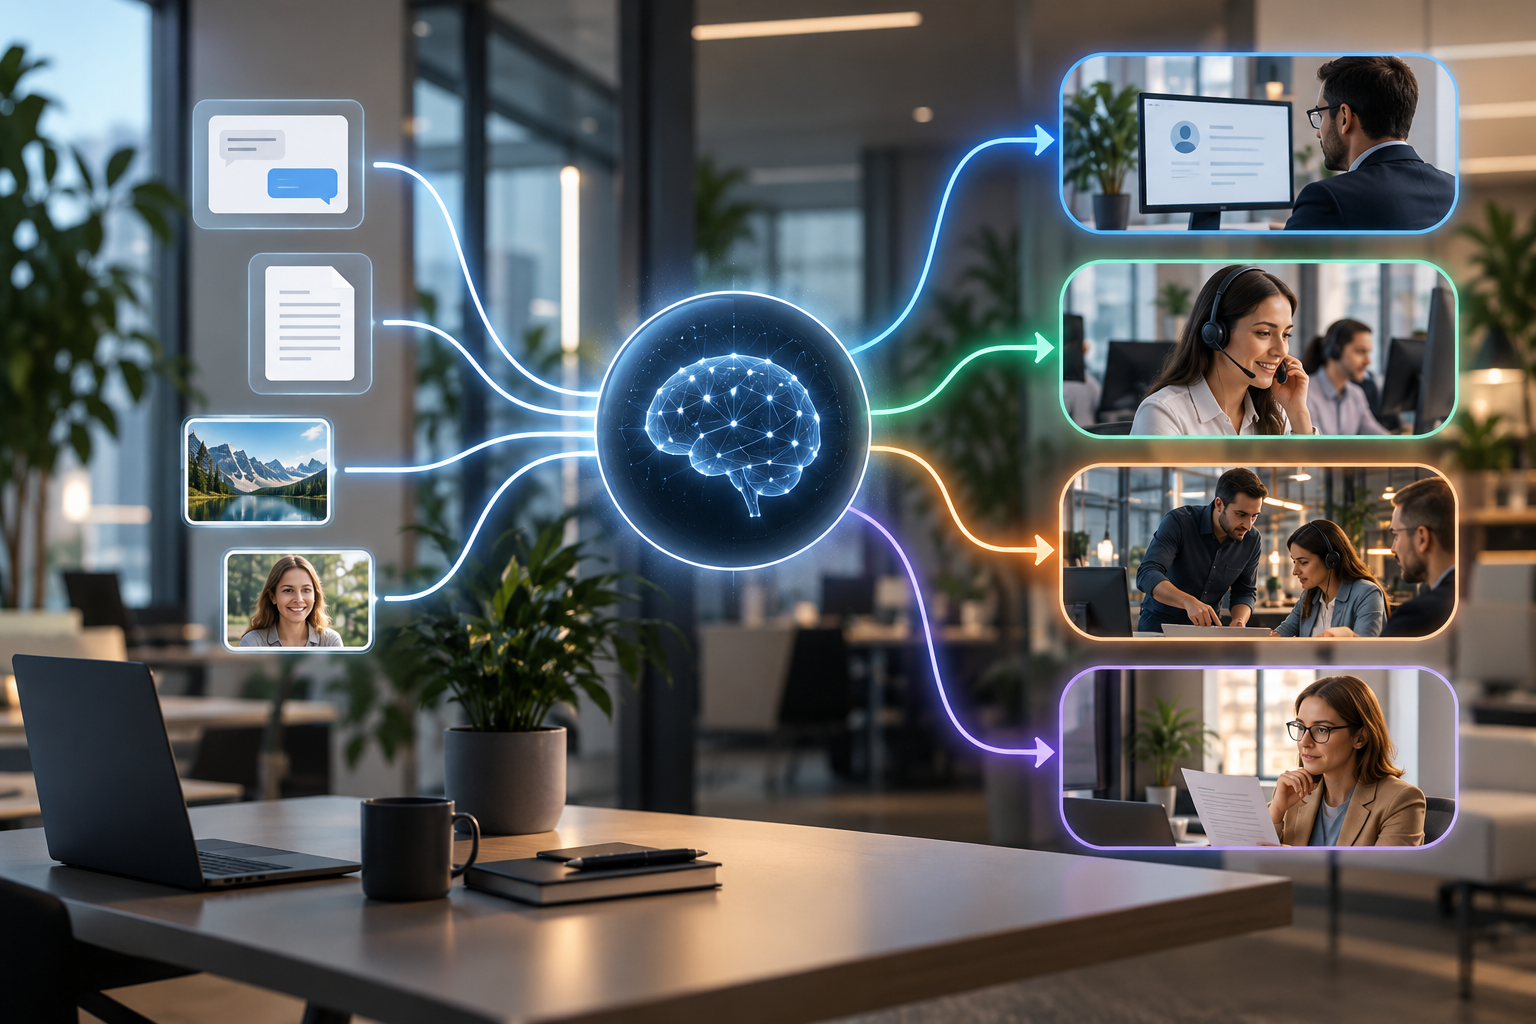
Illustration conceptuelle de l’orientation des données vers les workflows métier, et non photographie réelle du service.
Le CRM doit garder une voie de recours
Une automatisation utile repose sur des catégories comprises par les équipes. Des libellés vagues entraînent des orientations incohérentes et rendent les corrections difficiles à analyser. Chaque catégorie doit correspondre à une action précise, à un responsable identifié et à une règle de reprise manuelle.
| Situation métier | Sortie attendue | Garde-fou opérationnel |
|---|---|---|
| Demande reçue dans le CRM | Catégorie commerciale définie | Relecture des cas ambigus |
| Photo jointe à un retour | Signalement d’un dommage visible | Validation par le service concerné |
| Message adressé au support | Niveau issu d’une grille interne | Revue avant action sensible |
| Contenu soumis à publication | Classe de conformité éditoriale | Approbation par un responsable |
L’estimation fournie par le modèle ne constitue pas une certitude. Elle alimente une règle décidée en interne : poursuivre le traitement, envoyer le dossier en revue ou bloquer l’action. Le degré de contrôle doit suivre les conséquences d’une erreur. Une mauvaise affectation interne se corrige simplement. Un refus client, une modification contractuelle ou une décision liée à une personne réclame une intervention humaine formalisée.
Le CRM doit aussi enregistrer les corrections. Lorsqu’un collaborateur modifie une catégorie, il indique le motif et conserve le lien avec le dossier d’origine. Cette boucle révèle les consignes mal définies, les cas absents de la grille et les écarts entre le vocabulaire du modèle et celui des équipes.
Versionner les règles avant le passage en production
La gouvernance commence par l’inventaire des données envoyées au service. Messages commerciaux, photographies, pièces jointes et notes CRM contiennent parfois des informations personnelles, confidentielles ou contractuelles. Les ressources de la CNIL consacrées à l’intelligence artificielle aident à cadrer la finalité, la collecte, la conservation et les responsabilités associées au traitement.
Le niveau d’encadrement dépend également de l’usage et de ses effets sur les personnes. Le cadre réglementaire européen de l’intelligence artificielle organise les obligations selon les risques liés au système. Une PME doit donc documenter la finalité du workflow, les données utilisées, les personnes concernées, les modalités de supervision et les traces conservées.
Le statut de bêta renforce l’intérêt d’un environnement séparé des opérations critiques. Les consignes, catégories et règles de validation doivent être versionnées. Chaque modification nécessite un test sur des cas représentatifs, avec des données maîtrisées. Le journal de traitement doit relier la version de la règle, la réponse produite et la décision humaine, sans conserver des informations au-delà du besoin défini.
L’action interne à engager consiste à sélectionner un workflow limité et à rédiger sa fiche de décision. Celle-ci précise les entrées autorisées, les catégories reconnues, les actions associées, les situations renvoyées à un collaborateur et le responsable de chaque règle. Cette base donne à l’expérimentation un cadre vérifiable avant toute extension au CRM ou aux opérations.
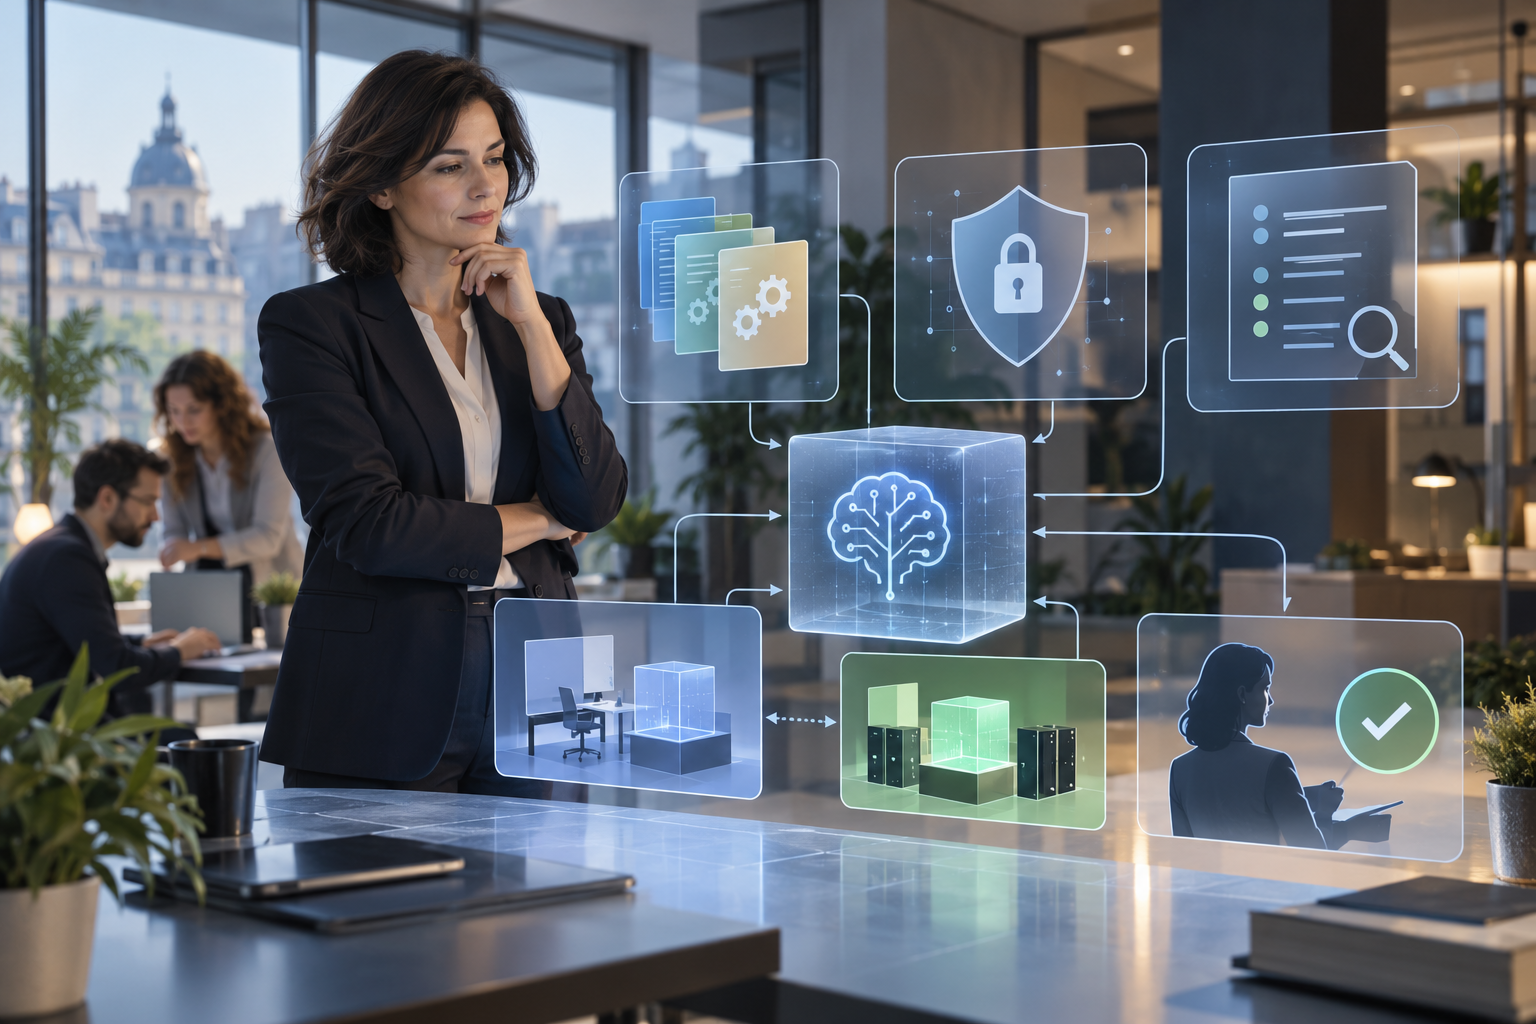
Illustration conceptuelle du versionnage et de la gouvernance d’un workflow automatisé, et non photographie réelle d’une solution déployée.