Floqer automatise la collecte d’informations utilisées pour identifier et comprendre des prospects B2B. Présentée comme une plateforme autonome de connaissance client, la solution rassemble, organise et actualise en continu des données destinées aux équipes commerciales et marketing, selon TechCrunch. Le fait nouveau ne réside donc pas dans un assistant qui rédige des messages, mais dans la constitution d’une base de recherche maintenue par l’IA.
Une base continue remplace les recherches dispersées
Le besoin visé précède la prise de contact. Pour trouver une entreprise correspondant à un profil donné, les commerciaux consultent habituellement des moteurs de recherche, des réseaux professionnels, des sites d’entreprise et des offres d’emploi, avant de rechercher les bons interlocuteurs et leurs coordonnées. TechCrunch décrit cette succession de recherches comme le problème auquel Floqer entend répondre.
Le mécanisme établi par la source comporte trois opérations : collecter des informations provenant de plusieurs espaces, les organiser dans une base exploitable et les mettre à jour de manière continue. Pour un responsable commercial, l’usage précis consiste à préparer la qualification d’un compte sans recommencer manuellement toute l’enquête à chaque campagne. La plateforme déplace ainsi le travail vers l’examen des informations réunies et leur utilisation pour sélectionner les entreprises à approcher.
Cette description ne permet toutefois pas de savoir comment Floqer rapproche deux mentions d’une même société, arbitre des sources contradictoires ou signale une information devenue obsolète. TechCrunch ne détaille pas non plus la manière dont les agents répartissent leurs tâches. L’autonomie qualifie donc le fonctionnement annoncé de la plateforme, pas un niveau de fiabilité démontré.
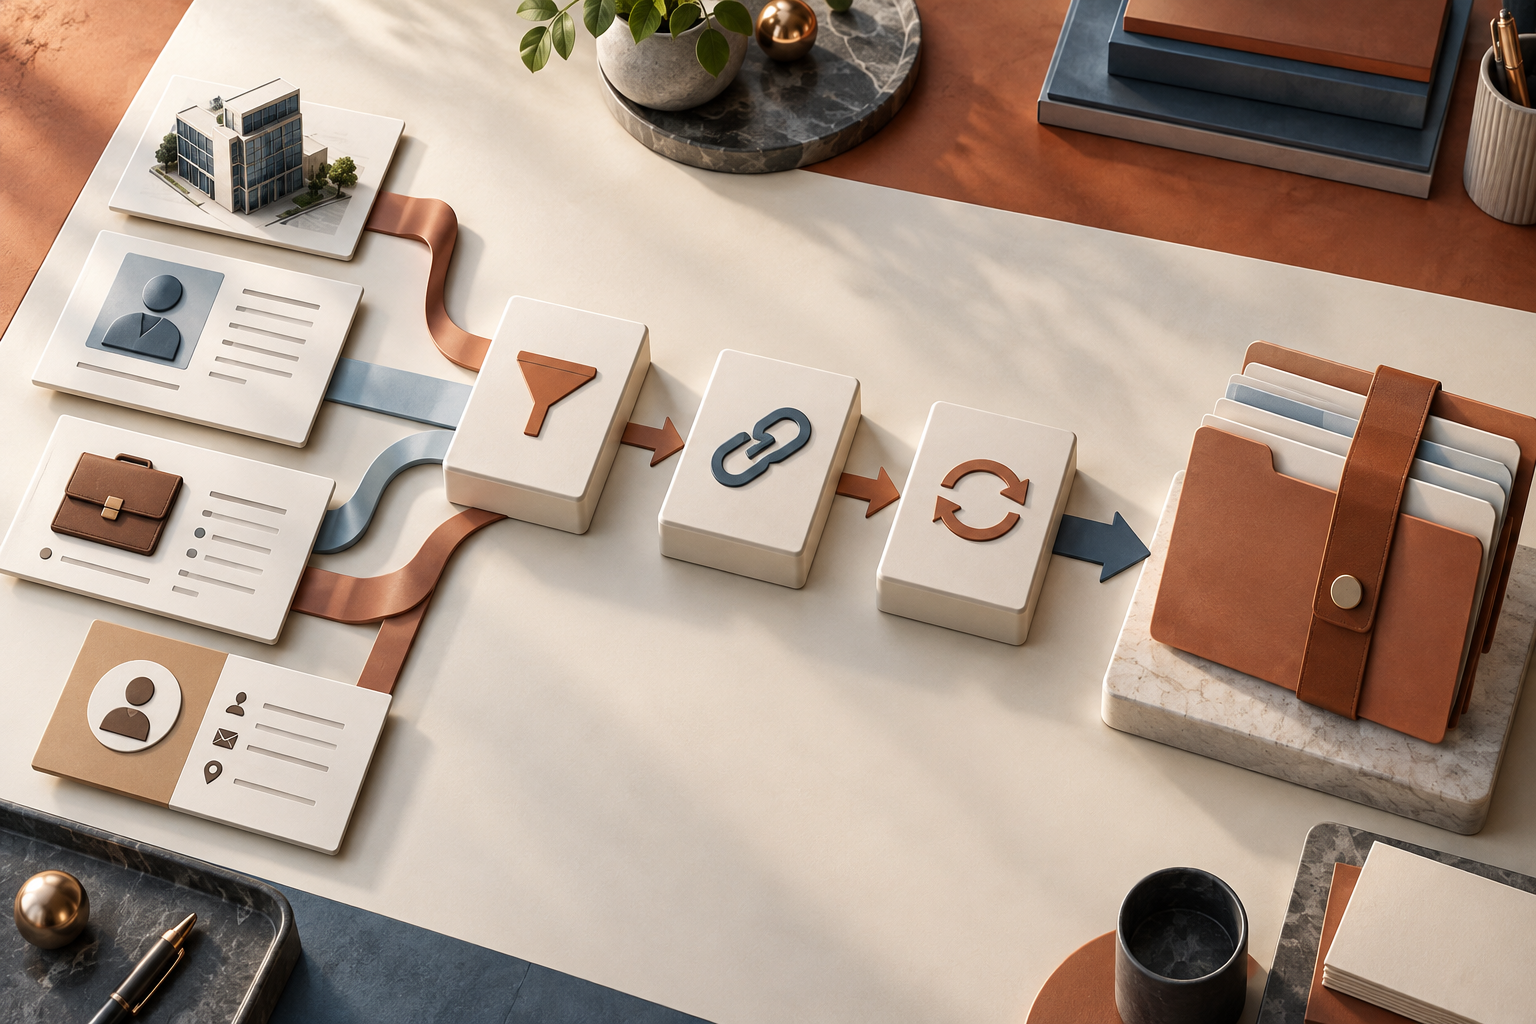
Illustration conceptuelle du passage de recherches dispersées à un dossier commercial unifié.
Le nettoyage des fiches clients a déclenché le pivot
Floqer n’était pas initialement conçu comme une base de connaissance commerciale. Son premier produit était une extension Chrome appelée Super Chat, destinée à comprendre des informations et à prendre des notes avec un compte ChatGPT. Des entreprises l’ont ensuite utilisée pour nettoyer les données de leur système de gestion de la relation client, d’après le récit des fondateurs rapporté par TechCrunch.
Shivam Mahajan, cofondateur et dirigeant de Floqer, attribue le changement de cap aux échanges menés avec ces entreprises. Elles lui auraient décrit un nettoyage largement manuel et dépourvu de processus établis pour maintenir les fiches à jour. Ce retour a conduit l’équipe à construire la plateforme actuelle, selon ses déclarations à TechCrunch.
Ce parcours éclaire le périmètre du produit : la recherche de prospects et l’entretien des données clients relèvent ici d’un même problème de connaissance commerciale. Une fiche enrichie n’a pourtant de valeur opérationnelle que si ses informations sont assez récentes et correctement rattachées à la bonne entreprise. L’annonce établit l’intention d’actualisation continue, sans publier de mesure permettant d’en apprécier la qualité.
La traction commerciale ne mesure pas la précision
Floqer affirme avoir dépassé 1,2 million de dollars de revenus récurrents annuels et multiplié son revenu global par environ dix en un an, chiffres communiqués par l’entreprise à TechCrunch. Ces données indiquent une adoption commerciale, mais elles ne constituent ni un test de fraîcheur des fiches ni une comparaison avec une recherche menée manuellement.
La source ne fournit aucun échantillon de dossier produit, aucun taux d’erreur et aucune évaluation indépendante. Elle ne chiffre pas davantage le temps économisé par un commercial. Il serait donc injustifié de déduire des revenus annoncés que la plateforme trouve systématiquement le bon interlocuteur ou remplace l’ensemble du travail de qualification.
Pour évaluer cet usage, les preuves les plus utiles concerneraient les éléments directement liés au mécanisme : provenance visible de chaque information, date de collecte, traitement des contradictions et résultat obtenu sur une liste de comptes déjà connue de l’équipe. Ces critères ne sont pas des capacités confirmées de Floqer ; ils définissent les informations qui manquent encore pour juger la base annoncée.
L’ouverture du moteur reste conditionnelle
Floqer prévoit de publier en logiciel libre la technologie placée derrière sa base autonome au début de 2027, sous réserve de contrôles de sécurité, d’après l’échéance transmise à TechCrunch. Il s’agit à ce stade d’un projet de publication, pas d’un dépôt déjà accessible ni d’une licence annoncée.
Cette ouverture pourrait rendre inspectable une partie du mécanisme, mais elle ne démontrera pas à elle seule la qualité des informations collectées. Le prochain élément décisif sera la publication effective du code accompagnée d’une documentation sur les sources, les mises à jour et la résolution des données conflictuelles. En attendant, Floqer présente un usage commercial bien délimité : réduire la recherche dispersée avant la prospection, avec une efficacité qui reste à établir par des résultats vérifiables.
Illustration conceptuelle du projet d’ouverture du moteur après les contrôles annoncés.