CedarDB a annoncé la disponibilité limitée de CedarDB Cloud après une phase bêta menée auprès d’utilisateurs inscrits sur liste d’attente, rapporte TechCrunch. Le fait nouveau ne réside donc pas dans la création du moteur, déjà proposé sous d’autres formes, mais dans l’ouverture progressive d’une version hébergée.
Son intérêt pour les agents IA tient à une caractéristique précise : CedarDB affirme pouvoir traiter dans le même moteur les transactions courantes et les requêtes analytiques. Cette réunion vise les entreprises dont les données historiques sont bien conservées, mais restent difficiles à interroger rapidement en langage naturel.
Un seul moteur relie opérations et analyse
Les bases opérationnelles enregistrent notamment les commandes et les paiements, tandis que les bases analytiques servent à explorer les données et à dégager des tendances. CedarDB remet en cause cette séparation en prenant en charge les deux types de requêtes, selon la présentation recueillie par TechCrunch.
Le mécanisme répond à un besoin identifiable pour un agent IA : confronter une question à la fois aux événements récents et à l’historique de l’entreprise. Dans un scénario hypothétique, un agent chargé d’examiner une baisse de commandes devrait consulter les opérations en cours, puis les comparer aux périodes précédentes. Une architecture séparée impose généralement que ces deux univers soient rendus accessibles au même processus.
CedarDB propose de rapprocher ces traitements au niveau du moteur. La source ne démontre toutefois pas que cette approche élimine toute copie, préparation ou transformation des données dans un déploiement réel. Elle établit le principe technique revendiqué, pas la simplicité de chaque intégration.
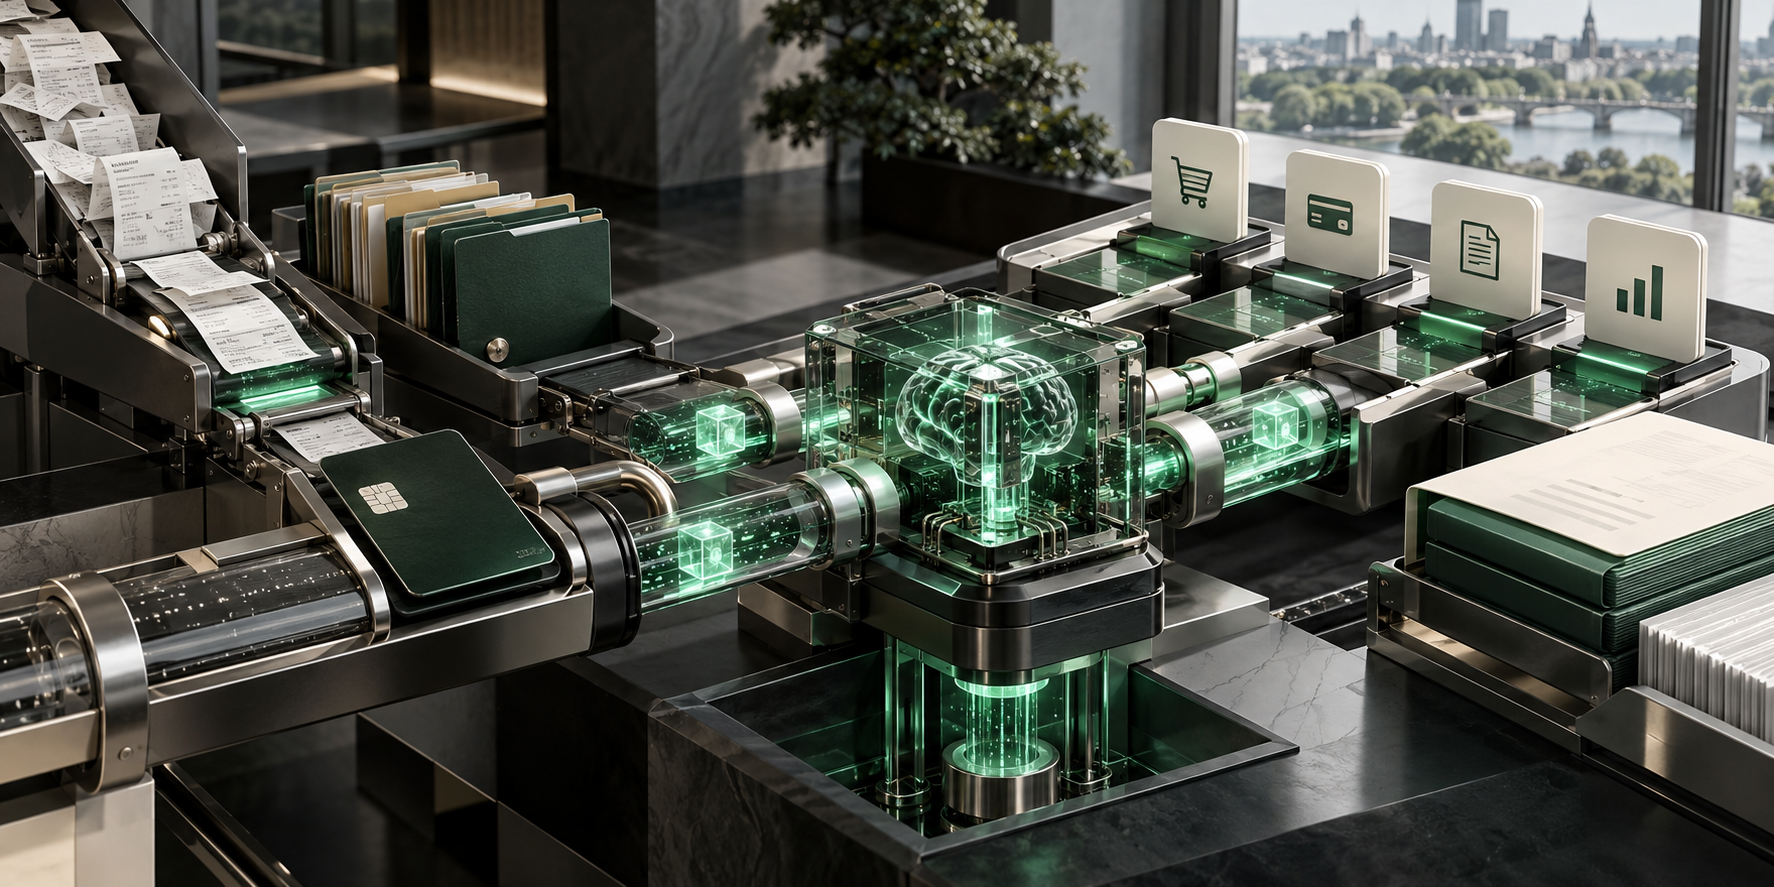
Illustration conceptuelle du rapprochement entre traitements opérationnels et analytiques dans un même moteur.
PostgreSQL sert de voie de migration
CedarDB provient d’Umbra, un projet de recherche de l’Université technique de Munich consacré à l’exploitation efficace du matériel moderne. L’entreprise affirme obtenir de meilleures performances sans exiger davantage de processeurs, de mémoire ou de puissance de traitement, tout en limitant les changements demandés aux utilisateurs, indique TechCrunch. Il s’agit ici d’une promesse de l’éditeur, et non d’un résultat comparatif publié dans l’article.
La compatibilité avec PostgreSQL constitue le levier de migration mis en avant. Moritz Sichert, cofondateur et dirigeant de CedarDB, explique qu’elle doit réduire les coûts de changement en évitant de reconstruire les applications. Il ajoute que les grands modèles de langage connaissent déjà largement la logique de PostgreSQL du fait de leurs données d’entraînement, d’après ses propos cités par TechCrunch.
Cette compatibilité relie donc deux besoins : conserver les applications existantes et fournir aux agents un environnement de requête familier. L’article ne précise cependant ni l’étendue exacte de la compatibilité ni les adaptations requises pour une application donnée.
Illustration conceptuelle du rôle de la compatibilité PostgreSQL dans le remplacement du moteur de données.
Le cloud élargit l’accès sans généraliser l’offre
Avant CedarDB Cloud, l’entreprise proposait une édition Enterprise installée sur site et une édition Community gratuite. L’équipe avait débattu d’un lancement immédiat dans le cloud avant de le reporter, puis de tester l’offre auprès de sa liste d’attente, relate TechCrunch.
L’hébergement doit retirer une partie de l’exploitation technique nécessaire à une installation locale. TechCrunch estime qu’une version entièrement gérée peut aider CedarDB à toucher des organisations au-delà des grandes entreprises. La disponibilité reste néanmoins limitée : la source ne fournit pas les critères d’accès, les conditions de service, la tarification ou le calendrier d’une ouverture générale.
Pour une PME, l’annonce marque ainsi le début d’une option à examiner plutôt qu’une offre déjà documentée pour un déploiement courant. Le cloud facilite l’accès au moteur, mais ne prouve pas encore son adéquation à une charge métier précise.
La charge réelle d’un agent reste à mesurer
L’article ne publie aucun test comparant CedarDB à une architecture séparant transactions et analyse. Il ne présente pas non plus de cas client détaillé dans lequel un agent IA interroge des données opérationnelles en production. Les gains de vitesse et d’efficacité restent des affirmations de CedarDB rapportées par la source.
Une évaluation utile doit donc partir d’une requête métier mêlant données récentes et historique : analyse de commandes, suivi de paiements ou interrogation d’un catalogue actif. Le même parcours peut alors servir à observer la justesse des réponses, le temps de traitement, les ressources consommées et les modifications imposées aux applications existantes.
CedarDB Cloud mérite une expérimentation ciblée lorsque la séparation entre base opérationnelle et base analytique ralentit déjà un projet d’agent IA. Si le choix dépend d’une offre cloud largement accessible ou de performances comparatives vérifiées, l’annonce ne suffit pas encore. Le prochain élément décisif sera la publication de tests reproductibles sur des charges mêlant transactions actives et questions analytiques.